毎月同じ形式のファイルを集計しているなら、その小さな処理でPythonを学べます。40代・50代の非エンジニアでも、仕事で知っている正しい結果と比べながら練習できます。一方、1枚の表を時々集計するだけなら関数やピボットで足りることもあります。繰り返す作業に合う道具としてPythonを選べます。
ここでは学習用のCSV4行を集計します。追加パッケージは使わず、元データを上書きしない構成です。入門課題の完成と会社で使える自動化、エンジニア転職は別の段階として扱います。
同じファイル処理を繰り返すならPython、単発の集計なら表計算で足りる場合がある
繰り返すファイル処理には、Pythonだけでなく表計算の取込・変換機能も使えます。実務ではどの列を読むか、どんな入力なら止めるかを先に決めます。何を書き出すかに加え、仕様が変わったときや動かなくなったときに対応する人も決めます。認証や画面変更が関わる画面操作の自動化は、この入門教材では扱いません。
人によって判断が違う仕事では、まず何を正しい結果とするかをルールにまとめます。今回の4行集計は表計算でもできますが、Pythonの条件分岐や繰り返しとファイル処理を結び付ける練習になります。
この小さな処理の中で、変数・条件分岐・繰り返し・関数を学べます。まず4件のデータがどう集計されるかを追いながら、使われている文法を学びます。どの入力で止まるか、結果をどこへ書き出すかもコードと対応させて読めます。
文字列と整数は金額の読取りに使い、繰り返しと辞書はチーム別の加算に使います。条件分岐と例外は不正な入力で止めるための機能です。ファイル操作は入力を読み、新しい出力を作るために使います。コードの各行と4件のデータを対応させると役割を追えます。
Python公式のcsv資料では、CSVから読んだ値は通常文字列であり、型変換は自動ではないと説明されています。またopenの公式資料では、xモードはファイルが既に存在すると失敗する新規作成モードです。
4件の入力を集計すると、Aは1,500円・Bは800円になる
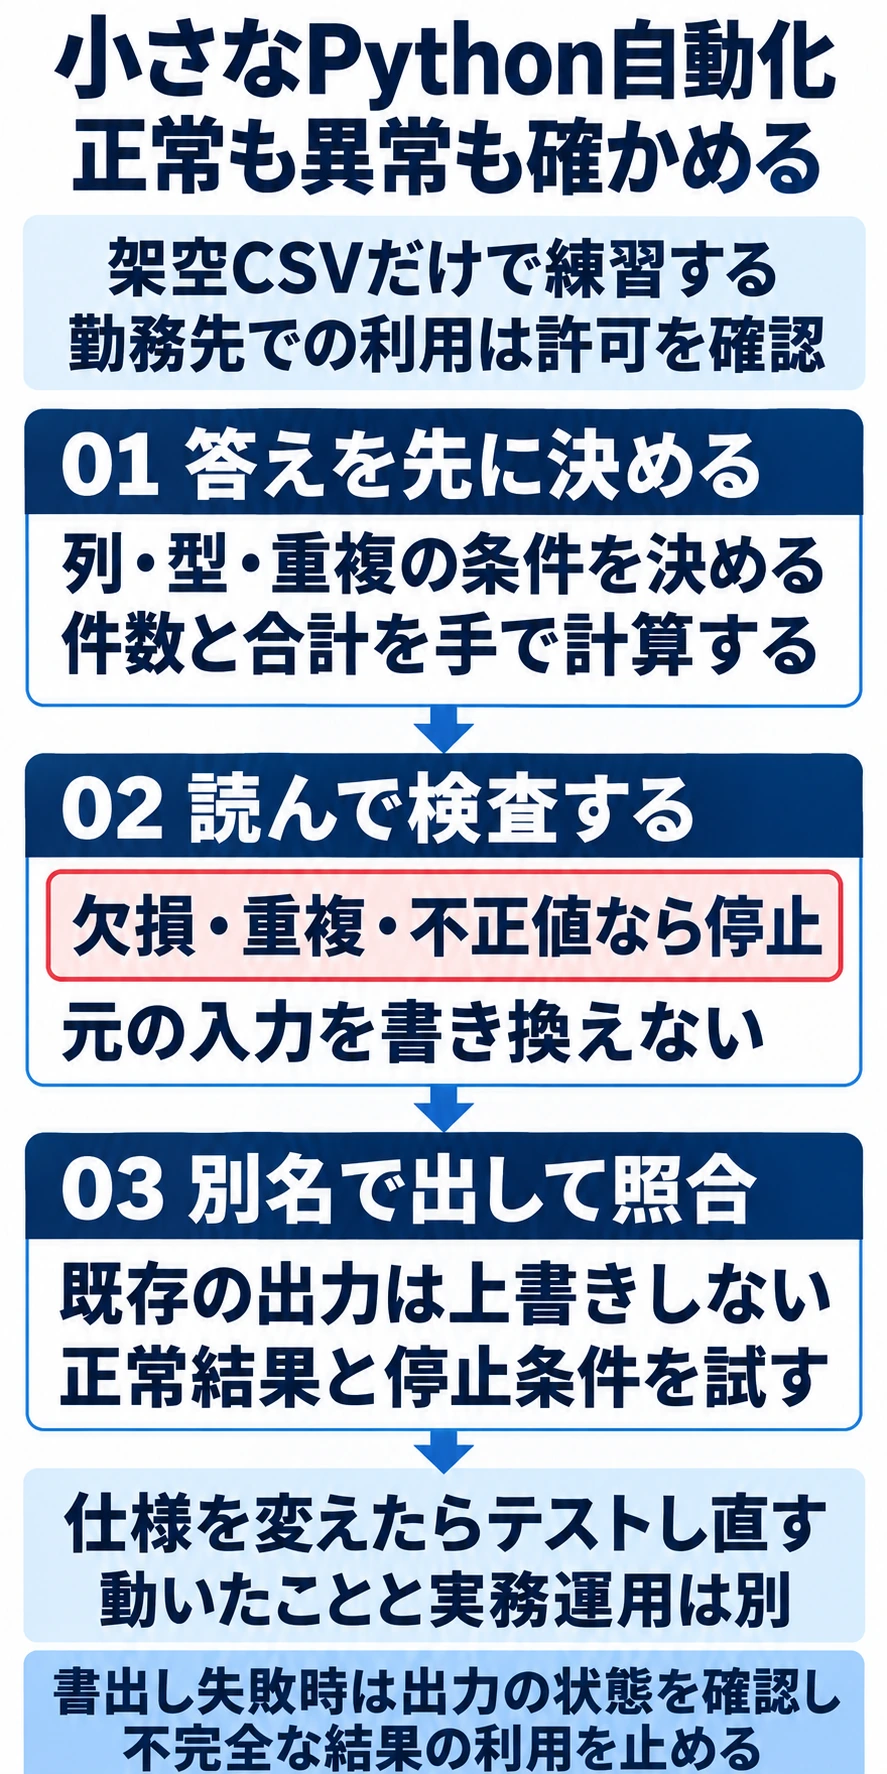
以下は架空の精算記録を模した教材で、人名・会社名・実取引を含みません。入力の列名と順序はid→team→amount_yenに固定します。teamはAかBで、金額は0以上の半角整数です。IDはRと半角数字2桁とし、重複なしの条件です。
勤務先の端末やデータを使う前に、利用できる環境と保存先の許可を確認します。初回はこの架空教材だけを新しい練習用フォルダに置きます。外部への送信や実データの変更には使いません。一括リネームや定期実行にも広げません。
Python 3が使える環境で、次の内容をUTF-8のsample.csvとして保存します。CSVはカンマで列を区切るテキスト形式です。文字コードを自動推測する教材ではなく、UTF-8(BOM付きも可)だけを読みます。完全な空行は読み飛ばし、エラー位置はレコードが終わる物理行番号で表示します。引用符の中に改行がある場合も、最後の行を示します。
id,team,amount_yen
R01,A,1200
R02,B,800
R03,A,300
R04,B,0
期待する出力はAが2件・1,500円、Bが2件・800円です。全体は4件・2,300円で、R04の0円も1件として数えます。
team,count,total_yen
A,2,1500
B,2,800
コードは入力を読み取り、新しいファイルだけに結果を出す
次のコードをsummarize.pyとして、sample.csvと同じ練習用フォルダへ保存します。Python標準ライブラリだけを使うため、追加パッケージのインストールは不要です。会社端末でPythonが使えなければ勝手に導入せず、担当者へ確認してください。
"""架空CSV専用の入門教材。ネットワーク接続・元データ更新なし。"""
import csv
import re
import sys
from pathlib import Path


def summarize(source, target):
    source, target = Path(source), Path(target)
    if source.resolve() == target.resolve():
        raise ValueError('入力と出力は別ファイルにしてください')
    totals = {'A': [0, 0], 'B': [0, 0]}
    seen = set()
    with source.open('r', encoding='utf-8-sig', newline='') as f:
        reader = csv.DictReader(f, strict=True)
        if reader.fieldnames != ['id', 'team', 'amount_yen']:
            raise ValueError('列名と順序が仕様と違います')
        for row in reader:
            line = reader.line_num
            if None in row or any(v is None for v in row.values()):
                raise ValueError(f'終端{line}行目のレコード: 列数が違います')
            item_id, team, amount = (row[k] for k in reader.fieldnames)
            if not re.fullmatch(r'R[0-9]{2}', item_id):
                raise ValueError(f'終端{line}行目のレコード: ID形式が違います')
            if item_id in seen:
                raise ValueError(f'終端{line}行目のレコード: IDが重複しています')
            if team not in totals:
                raise ValueError(f'終端{line}行目のレコード: teamはAかBです')
            if not re.fullmatch(r'[0-9]+', amount):
                raise ValueError(f'終端{line}行目のレコード: 金額は0以上の整数です')
            seen.add(item_id)
            totals[team][0] += 1
            totals[team][1] += int(amount)
    if not seen:
        raise ValueError('データ行がありません')
    # 全件を確認してから、存在しない出力ファイルだけを作る。
    with target.open('x', encoding='utf-8', newline='') as f:
        writer = csv.writer(f, lineterminator='\n')
        writer.writerow(['team', 'count', 'total_yen'])
        for team, values in totals.items():
            writer.writerow([team, *values])
    return len(seen)


if __name__ == '__main__':
    if len(sys.argv) != 3:
        raise SystemExit('使用方法: python summarize.py sample.csv result.csv')
    try:
        count = summarize(sys.argv[1], sys.argv[2])
    except (ValueError, OSError, UnicodeError, csv.Error) as exc:
        raise SystemExit(f'停止: {exc}')
    print(f'完了: 入力{count}件。出力を確認してください')
そのフォルダを開いたターミナルで、次のコマンドを実行します。環境で実行名がpython3の場合は、先頭だけpython3に置き換えてください。
python summarize.py sample.csv result.csv完了と表示されたら、result.csvが上の期待出力と同じかを見ます。Aは2件・1,500円、Bは2件・800円です。元のsample.csvが変わっていないことも確かめます。動いたかどうかに加え、結果が正しいかまでが練習です。
| コードの場所 | 読むときの意味 |
|---|---|
| csv.DictReader | 1行目を列名として、データ行を列名で取り出す |
| if と raise ValueError | 条件に合わない入力を、合計結果に混ぜず停止する |
| seen と totals | 読んだIDの重複を確認し、チーム別の件数・金額を更新する |
| target.open の x | 既存ファイルを壊さず、新しいファイルだけへ結果を出す |
| try / except | 想定したエラーを捕まえて停止理由を表示する |
重複や負数を入れると、新しい出力を作る前に止まる
この教材は列名の不一致や重複IDがあると停止します。負数・小数や空のデータなども、正常な入力とは分けて練習する対象です。実行前に入力条件を確かめ、条件を満たさない場合は表示された理由と元データを照らし合わせてください。
| 自分でも試す変更 | 期待する結果 | 確認するもの |
|---|---|---|
| R01の金額を-1へ変える | 金額のエラーで停止 | 新しい出力を作らず、入力も書き換えない |
| 最後へR01,A,100を追加する | ID重複で停止 | 二重計上した合計を出さない |
| 同じresult.csvを指定して再実行 | 既存出力があるため停止 | 前回の結果を上書きしない |
| 別名result2.csvで再実行 | 同じ内容の結果を新しく出す | 元データと前回結果を残す |
エラーを試すときはsample.csvをコピーして編集します。止まった理由が分からないまま入力チェックを消してはいけません。出力モードをwに変えると既存ファイルを上書きできるようになります。この教材では、止まる理由を理解してxのまま使います。
入力の不正は新しい出力を作る前に停止し、既存の出力は上書きしません。新規ファイルを書き出す途中でディスク等のエラーが起きると、不完全な出力が残る可能性があります。失敗表示が出た出力は使いません。本番では原子的な出力を別に設計します。書き込みの途中で失敗しても完成した結果と取り違えないための仕組みです。同時に動かす場合の処理やログの残し方に加え、止まった後に直す人と保守する人も決めます。
求人では事務経験と自動化を仕事で使った経験の両方を求める例がある
2026年10月1日に確認したforestの営業事務・業務自動化の公式募集は、営業事務または営業アシスタントの経験と、指定された技術による改善の実務経験の両方を必須にしています。技術の選択肢には生成AIエージェントとPythonまたはSQL、GASがあります。すべての技術が必須という条件ではありません。
歓迎要件にはデータ品質の確認ルール・業務マニュアルの整備・複数部門の改善経験等も記載されています。今回の集計を動かせても、その実務経験を満たしたとはいえず、応募書類では「架空データを使った学習制作」と明記する必要があります。
この求人は事務経験と自動化の実務経験を求める一例です。40代・50代の採用の多さや、Pythonを学ぶことで給与が上がるかまでは示していません。
エラーを説明できたら、質問やレビューで次へ進む
コードが動いたら、正常な結果だけでなく止まる理由を説明できることが次の目標です。AIでコードを作る場合も入力条件と上書きの有無を読む力が必要になります。エラーの直し方が分からないなら、コードを見てもらえる講座が役立ちます。文法の動画を増やすより、自分のコードのどこが違うか説明してもらう方が困りごとに合います。
JEEDの令和8年度カリキュラムモデル(印刷68ページ)には、Pythonの基本とファイル操作を学ぶ訓練例があります。エラー処理等も対象です。6時間3,300円、12時間5,500円(税込)の設定例が示されていますが、全国どこでも同条件で今申し込める講座一覧ではありません。実施日・対象者・内容は各実施案内で確認します。
講座の外でも、入力を変えて結果を調べる時間が必要です。仕様を一つ変えたら、先に計算した件数・合計と実行結果を比べます。仕事へ導入するには利用許可が前提です。データの扱いに加え、コードを点検する人と運用後に責任を持つ人も決まっている必要があります。
生成AIの使い方や情報の扱いは生成AIの業務学習、仕事の流れを見直す考え方はDXの学び直しで詳しく扱っています。
資料・求人情報は2026年10月1日時点です。CSVとコードは限定した入力仕様を学ぶ教材で、求人は1社1職種の公開例です。
書いて整理したい方には、小さな自動化の設計・確認票(PDF)も使えます。