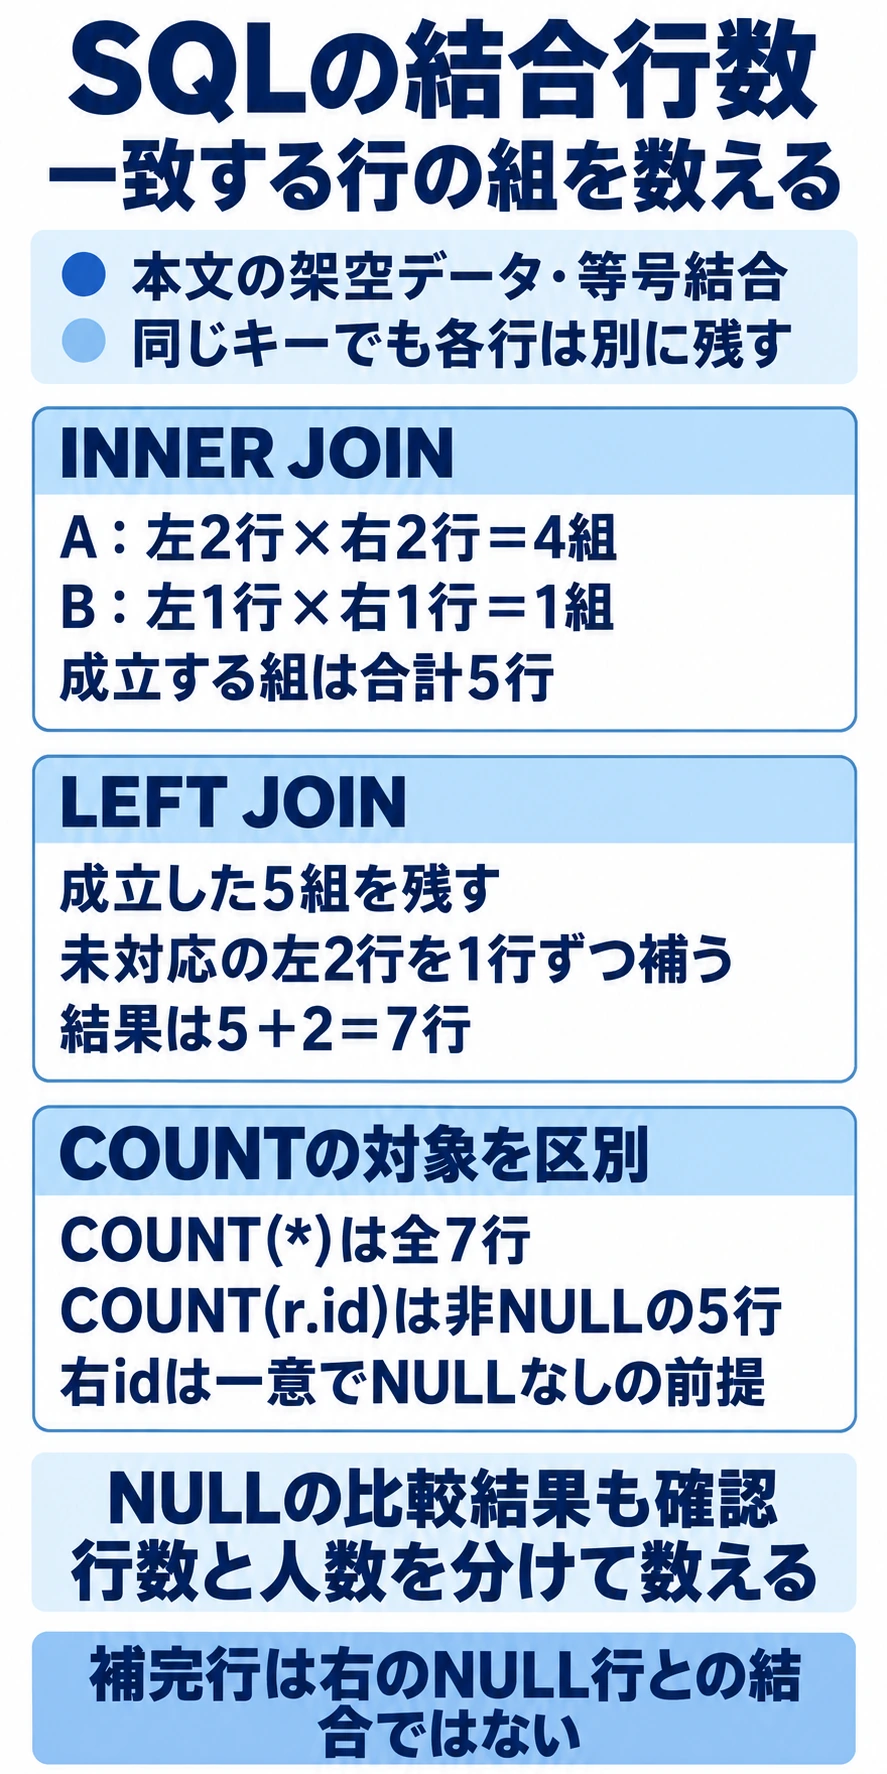
JOINの行数は、条件に一致する行の組の数です。左のAが2行、右のAも2行なら2×2=4組になります。通常の等号ではNULL同士も一致しないため、値が同じに見える行をまとめずに数えます。
この例は左が5行、右が4行です。INNER JOINでは一致した5組、LEFT JOINでは相手のいない左の2行も加えて7行になります。行IDの組で追うと、入力行数・結合後の行数・人数を区別できます。
- 等号による結合だけを扱う。照合するgrp列には重複とNULLがある
- 各表のidは一意でNULLにならない。grpは主キーではない
- NULLは文字列の「NULL」や空文字ではない。表では値がない位置をNULLと表記する
- WHERE・複数表の連鎖・製品ごとの型変換や照合順序は、この練習の範囲に含めない
同じAが左右2行ずつあれば4組になる
Aの組合せはL1とR1、L1とR2、L2とR1、L2とR2の4組です。learnersは研修候補者、coursesはグループ別の研修候補を表す架空データで、同じグループの行を対応させます。
| learners.id | grp |
|---|---|
| L1 | A |
| L2 | A |
| L3 | B |
| L4 | NULL |
| L5 | C |
| courses.id | grp | topic |
|---|---|---|
| R1 | A | X |
| R2 | A | Y |
| R3 | B | Z |
| R4 | NULL | W |
Aの研修候補者はL1とL2の2人で、Aの研修はR1とR2の2つです。L1にはR1とR2、L2にもR1とR2が対応します。同じAでも、候補者や研修が同じ行になるわけではありません。
INNER JOINの答えは5行でNULL同士の組は含まない
SELECT l.id AS learner_id, r.id AS course_id
FROM learners AS l
INNER JOIN courses AS r ON l.grp = r.grp
ORDER BY l.id, r.id;
Aの4組とBの1組を足して5行です。L1とR1、L1とR2のように行IDで数えると、同じAを1件にまとめる誤りを防げます。各比較の真・偽・不明は下の対応表に示しています。
対応する組とINNER・LEFTの結果を開く
| 左の行 | 右の行 | l.grp=r.grp |
|---|---|---|
| L1・L2(A) | R1・R2(A) | 真。2×2=4組 |
| L1・L2(A) | R3(B) | 偽。2組 |
| L1・L2(A) | R4(NULL) | 不明。2組 |
| L3(B) | R1・R2(A) | 偽。2組 |
| L3(B) | R3(B) | 真。1組 |
| L3(B) | R4(NULL) | 不明。1組 |
| L4(NULL) | R1〜R4(全行) | 不明。4組 |
| L5(C) | R1〜R3(A・A・B) | 偽。3組 |
| L5(C) | R4(NULL) | 不明。1組 |
| learner_id | course_id | 結果に含まれる方式 |
|---|---|---|
| L1 | R1 | INNER・LEFT |
| L1 | R2 | INNER・LEFT |
| L2 | R1 | INNER・LEFT |
| L2 | R2 | INNER・LEFT |
| L3 | R3 | INNER・LEFT |
| L4 | NULL | LEFTのみ。対応する右行がない |
| L5 | NULL | LEFTのみ。対応する右行がない |
等号比較が真になるのは、Aの2×2=4組とBの1×1=1組です。INNER JOINはこの5組を返します。Aという値を1件にまとめると、別々の行IDから作る組を落としてしまいます。
L4とR4は両方NULLでも、l.grp=r.grpが真にはなりません。通常の比較でNULLが関わると不明となる扱いを、PostgreSQLの公式比較演算子資料でも確認できます。
LEFT JOINは成立5組と未対応の左2行で7行
SELECT l.id AS learner_id, r.id AS course_id
FROM learners AS l
LEFT JOIN courses AS r ON l.grp = r.grp
ORDER BY l.id, r.id;
まず前の5組があり、右と1組も対応しなかった左行はL4とL5です。それぞれ右側をNULLにした1行を加えるので、LEFT JOINの結果は5+2=7行になります。
上の結果表でLEFTだけに含まれるのは、L4・NULLとL5・NULLです。L1〜L3に対応した5行はINNER JOINと共通です。
L4の結果はL4とR4が結合した行ではありません。もしR4と結合していればcourse_idはR4になるはずですが、結果のcourse_idはNULLで、右側に対応行がないことを表しています。
LEFT JOINが左の全行を残すというのは、結果が左表と同じ5行になるという意味ではありません。対応する右行が複数あれば、その左行は複数回現れます。PostgreSQLの公式JOIN説明とSQLiteの公式SELECT説明で、対応行と未対応行の扱いを確認しています。
COUNTは行・対応組・人数で7・5・3に分かれる
COUNT(*)は結合後の7行を数えます。COUNT(r.id)は右IDがNULLでない5行を数え、候補のある人数を求めるときは左IDの重複を除いた3人になります。
SELECT COUNT(*) AS result_rows, COUNT(r.id) AS matched_pairs
FROM learners AS l
LEFT JOIN courses AS r ON l.grp = r.grp;| 式 | 結果 | 数えたもの |
|---|---|---|
| COUNT(*) | 7 | 左外部結合後の全行。L4・L5の補完行を含む |
| COUNT(r.id) | 5 | r.idがNULLではない行。今回は実際に成立した対応組の行 |
| 入力表learnersの人数 | 5 | 元の左表の行数。上の2つの式と同じ意味ではない |
COUNT(r.id)の5は、研修候補がある人が5人という意味でもありません。対応する候補がある左の行IDはL1・L2・L3の3つで、L1とL2に各2行あるため対応組の数が5になります。
ここでCOUNT(r.id)を使えるのは、元の右表のidにはNULLが入らないと決めているからです。結合後のr.idがNULLなら、相手がなく補われた行だと分かります。もともとNULLが入る列を数えると、相手が見つかった行まで数え落とすことがあります。
もし求めるものが「研修候補に対応した人の数」なら、この例ではINNER JOINで成立した行から左IDの重複を除いて数えます。次のCOUNTは3になります。
SELECT COUNT(DISTINCT l.id) AS learners_with_courses
FROM learners AS l
INNER JOIN courses AS r ON l.grp = r.grp;
このSQLをLEFT JOINに変えると、同じCOUNT(DISTINCT l.id)でも答えは5です。候補のないL4・L5も残るためです。「候補がある人」を数えたいなら、重複を除くだけでなく、候補に対応した行だけを選ぶ必要があります。
右のAを1行増やすと結果は2行増える
元のcoursesへ、id=R5・grp=A・topic=Vの1行だけを追加した別条件を考えます。learnersは変えず、INNER JOINとLEFT JOINの行数、COUNT(r.id)がどう変わるかを考える練習です。
追加後の答えを開く
Aが左2行×右3行=6組となり、Bの1組を加えてINNERは7行です。未対応の左L4・L5は同じなのでLEFTは9行、COUNT(r.id)は7になります。
R5と結び付くのはL1とL2です。左の人数は5人、候補のある左行IDは3つのままで、対応組だけが2つ増えます。INNERからLEFTへ変えたときは、元と同じL4・L5の2行を補います。
右表が1行増えても、結果は1行だけ増えるとは限りません。この条件では追加行に対応する左行が2つあるため、結果は2行増えます。
2行はキーの種類、5行は結合した組の数
INNER JOINを2行とした場合は、AとBというキーの種類を数えています。必要なのはAの2×2とBの1×1を足した5組です。6行とした場合はNULL同士を1組加えた可能性がありますが、その比較は不明です。
LEFT JOINを5行とした場合は、左の同じ行が相手の数だけ繰り返される点を見落としています。COUNT(r.id)が5になるのは、補われた2行の右IDがNULLで、数える対象から外れるためです。入力にあるNULLと外部結合が補ったNULLを行IDで区別すると原因が分かります。
再現用SQLは空の練習用データベースで使う
再現用SQLは、新しく作った空の練習用データベースで実行します。本文のSELECTを試すための自作データを作るSQLです。既存の業務データベースでは実行しないでください。
テーブル定義とINSERTを開く
CREATE TABLE learners (
  id TEXT PRIMARY KEY NOT NULL,
  grp TEXT
);
CREATE TABLE courses (
  id TEXT PRIMARY KEY NOT NULL,
  grp TEXT,
  topic TEXT
);
INSERT INTO learners VALUES
 ('L1','A'),('L2','A'),('L3','B'),('L4',NULL),('L5','C');
INSERT INTO courses VALUES
 ('R1','A','X'),('R2','A','Y'),('R3','B','Z'),('R4',NULL,'W');
再テストは元のデータから開始し、次の1行を追加します。同じidを重ねて追加する練習ではないため、再試行時は新しい練習用データベースから作り直してください。
INSERT INTO courses VALUES ('R5','A','V');実行結果と手計算が同じかは、learner_idとcourse_idの組で比べられます。本文の対応表は答えを考えるための表で、データベース内部の処理順を表したものではありません。内部の処理方法は、利用するデータベースの実行計画で調べます。
試験では問題文のSQL仕様に合わせて学ぶ
試験問題を解くときは、問題文の定義とIPAが定めるSQLの仕様が基準です。基本情報シラバスVer.9.2にはNULL・表の結合・SELECT・集合関数などが含まれます。IPAの記述仕様はJIS X 3005規格群に従うとしているため、SQLite固有の機能とは区別します。
本稿は明示した等号結合・NULL・COUNTの小さな例に限定し、表示順をそろえるSELECTにはORDER BYを付けています。ORDER BYのない行の並びや暗黙の型変換は一般化しません。独自のNULL比較設定と文字列の大文字小文字の扱いなども、実際の試験問題の定義や注記を確認してください。
行の組合せを数えられるようになったら、手元の教材で条件を増やした問題へ進めます。NULLやCOUNTで数える行が分からなければ、データベースの基礎講義と講師への質問でその違いを学べます。
その場合は基本情報技術者の通信講座比較で、科目Aのデータベース分野と学習質問の対象範囲を比べられます。SQLは今回の科目Aデータベース分野に合う支援を選ぶのがポイントです。
一次資料と練習の範囲
- IPA 基本情報シラバスVer.9.2(PDF) データベース設計とデータ操作
- IPA 試験で使う用語・プログラム言語などVer.5.1(PDF) SQLの仕様と問題文の定義
- PostgreSQL公式 Table Expressions、公式 Comparison Functions 結合の対応とNULLの比較
- SQLite公式 SELECT、公式 Aggregate Functions 使用した環境での結合・COUNT
資料の確認日は2026年10月1日です。本文のデータとSQLは自作の練習用で、等号結合・NULL・COUNTの条件を限定して説明しています。
書いて整理したい方には、基本情報のSQLで結合後の行数を数える|重複キーとNULLの練習 回答用シート(PDF)も使えます。